この記事で分かること
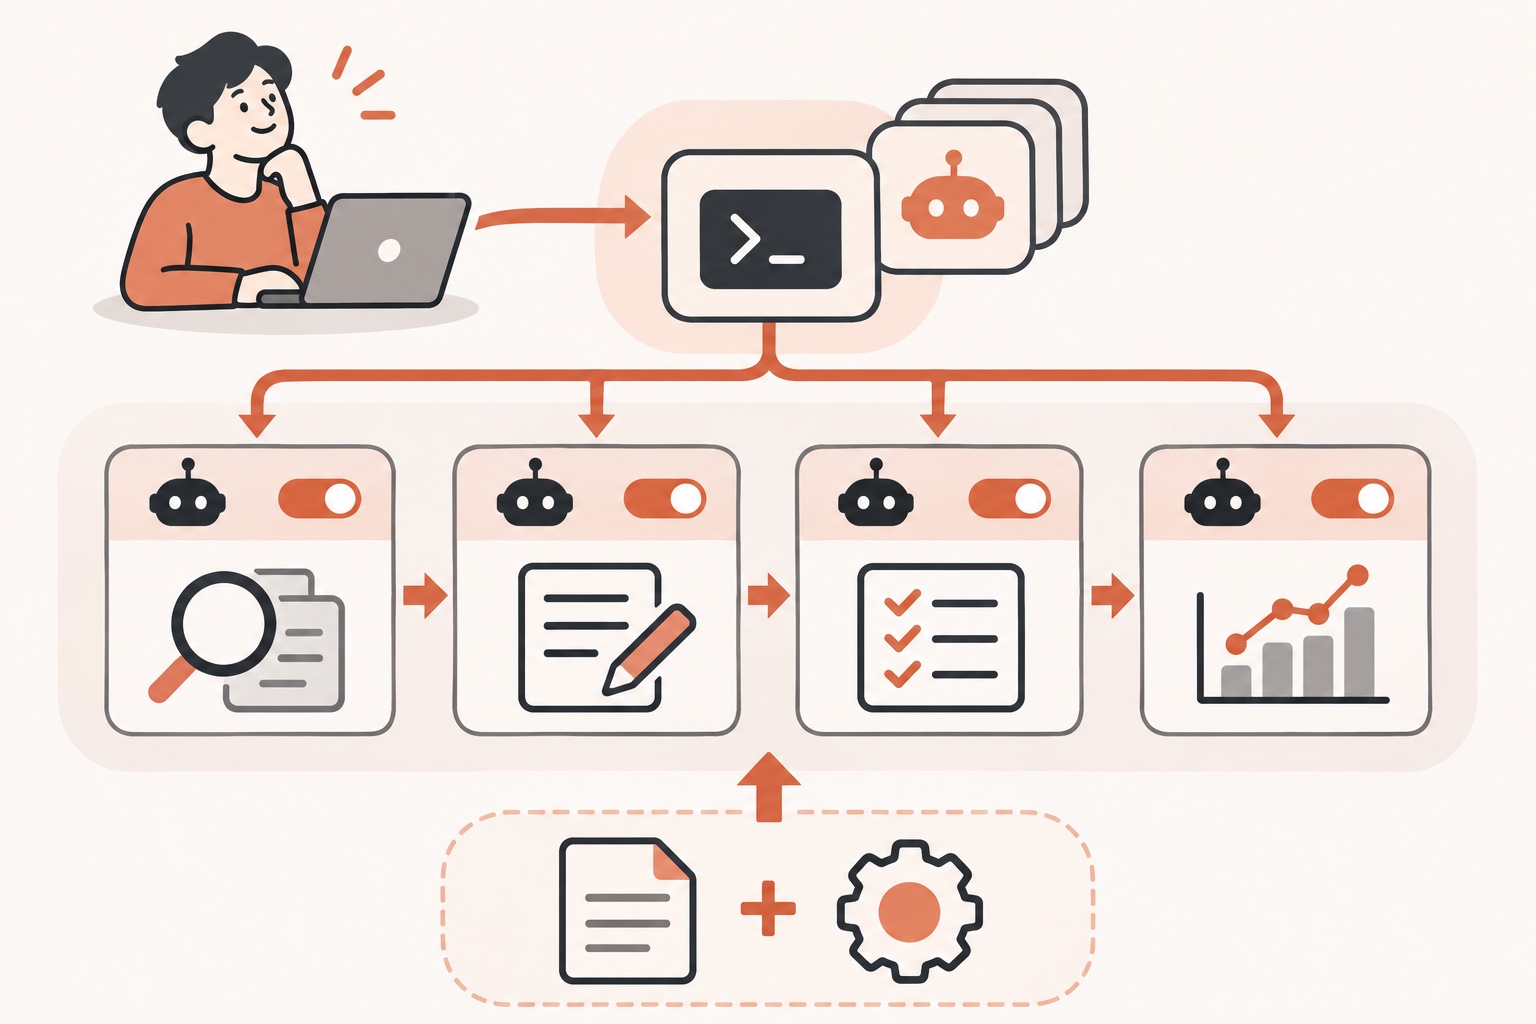
Threads運用のリサーチ・執筆・チェック・分析を1人で抱えて疲弊している副業・ひとり起業の方向けに、Claude Codeのサブエージェントと権限モードで役割分担する具体的な手順を解説します。対象は、投稿作成に1時間以上かかり継続が難しいと感じている方です。結論として、4つの工程を分担させる仕組みはサブエージェントとスキルの組み合わせで再現でき、最小構成ならCLAUDE.mdとスキル1本から始められます。
判断基準:どこまでをAIに任せるか
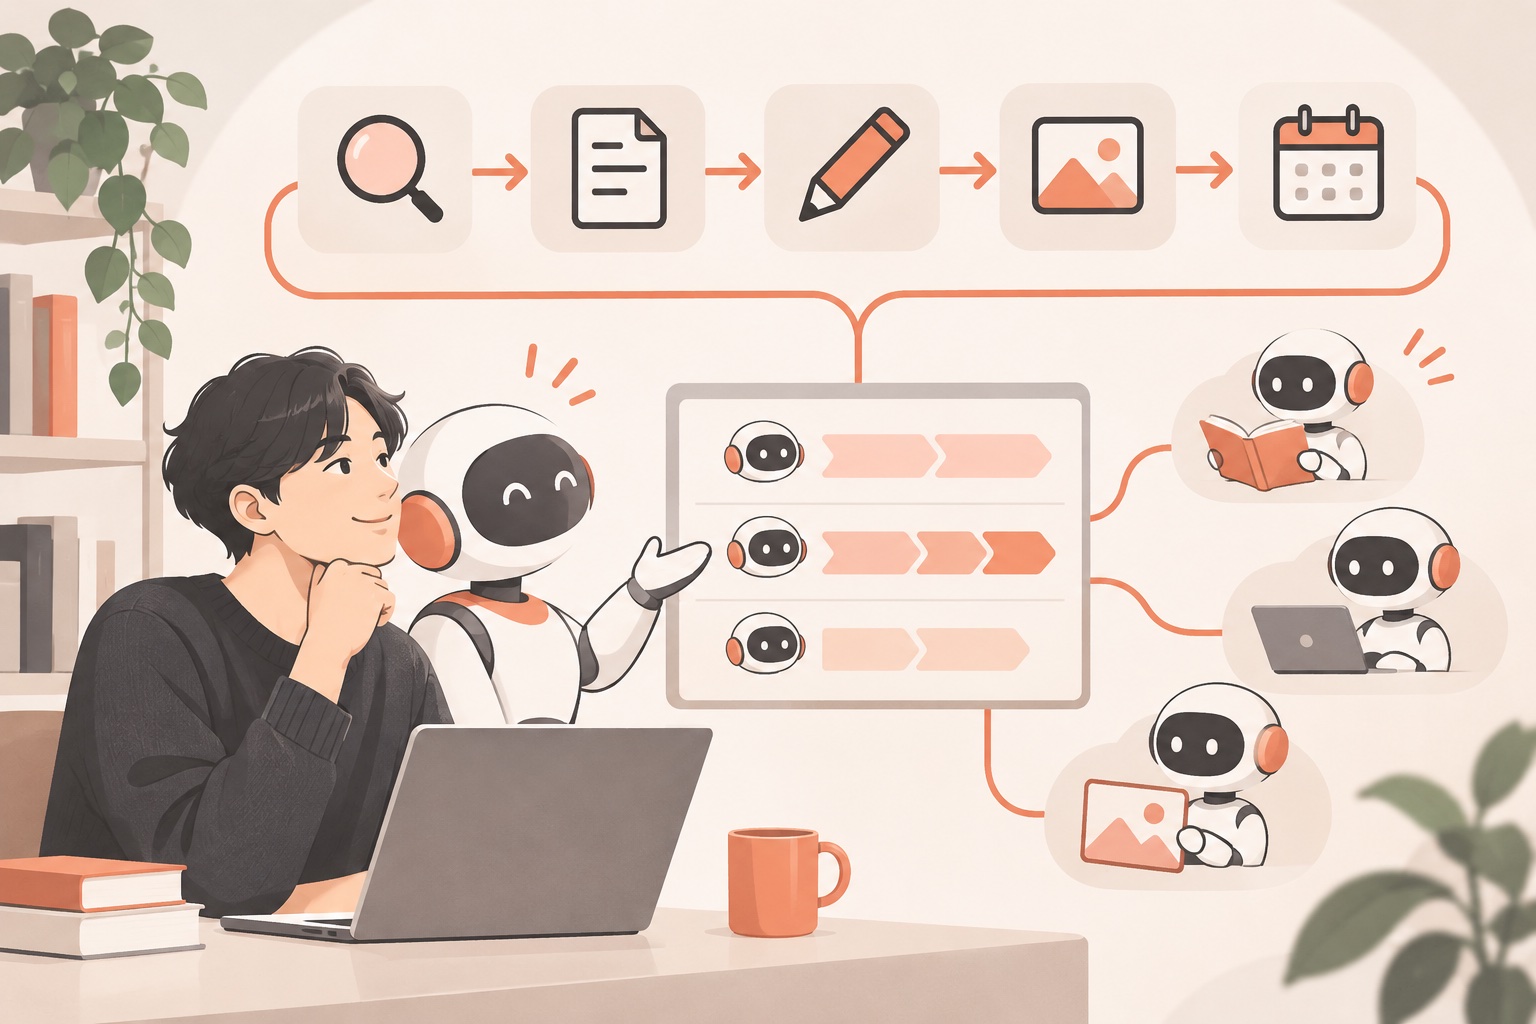
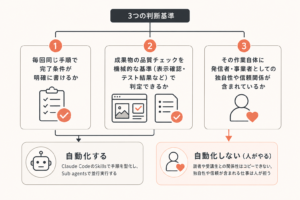
SNS投稿のリサーチ・執筆・確認・分析をすべて自分でこなすと、工程の切り替えだけで消耗してしまいます。判断基準は次の3つです。
- 繰り返す作業かどうか(繰り返すならスキル化の対象)
- 判断に数値基準を置けるかどうか(置けるなら機械的チェックに回せる)
- 最終承認を人が必要とするかどうか(公開前の確認は必ず人が行う)
この基準で分けると、リサーチと下書き作成はAIに任せやすく、公開判断は人に残す設計になります。
再現可能な手順:サブエージェントで4つの役割を分ける
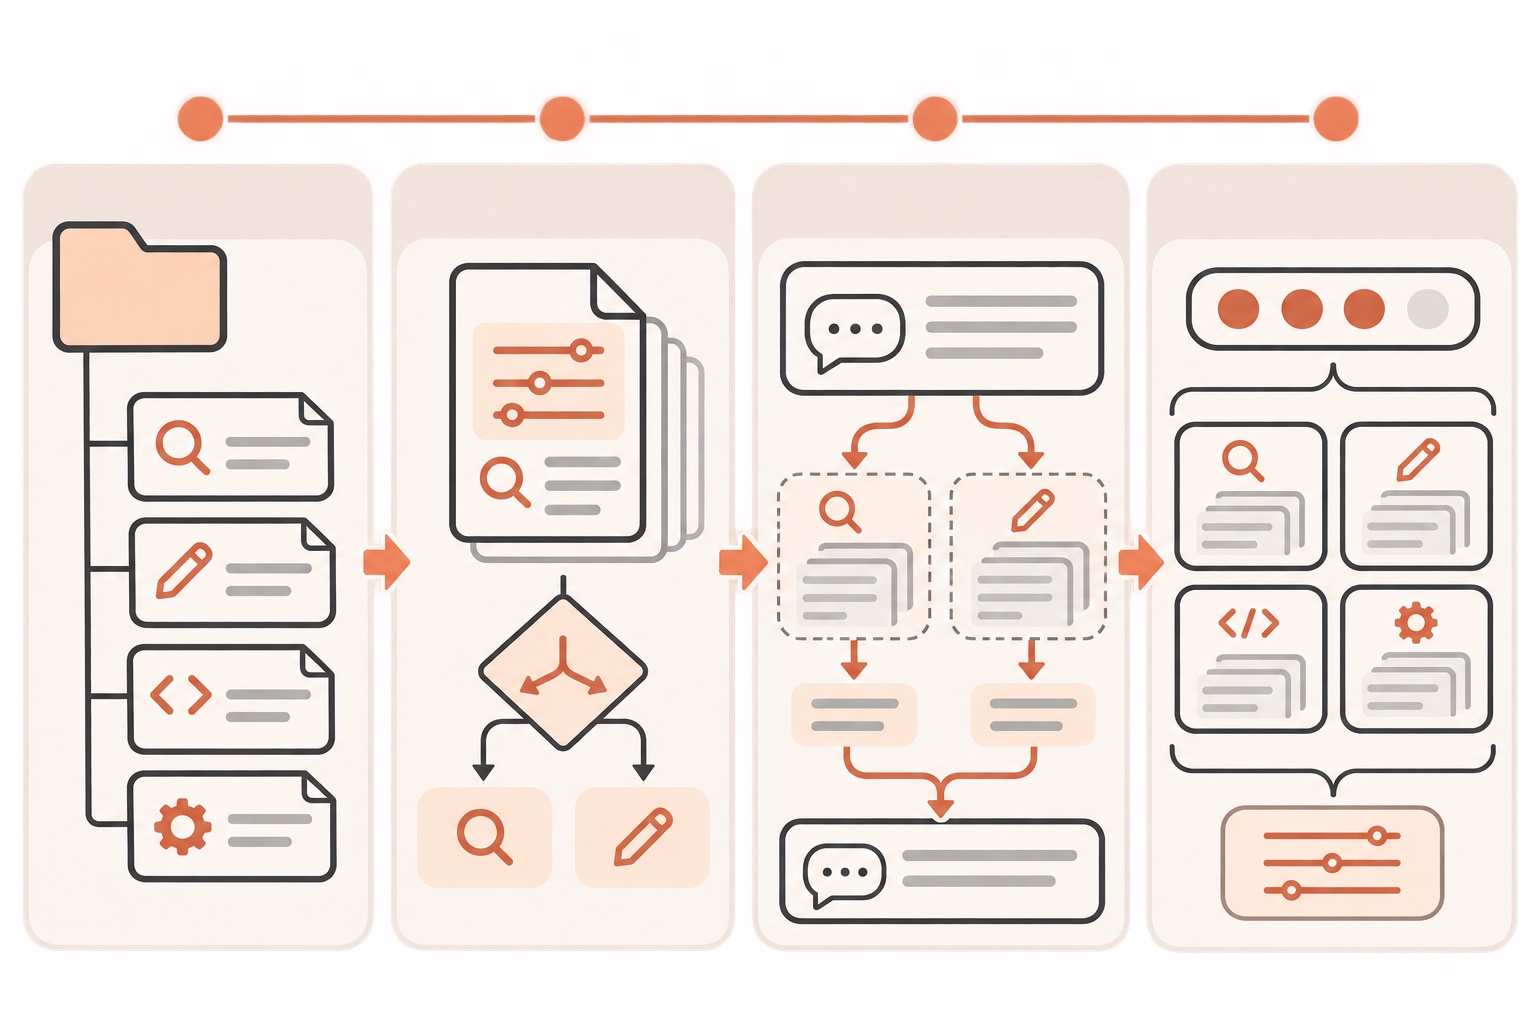
サブエージェントは自分専用の文脈で作業し、要約だけを本体の会話に返す仕組みです。検索結果やログで本体の会話を埋めずに済むため、リサーチ役と執筆役を分けても文脈が圧迫されません。
手順は次の通りです。
- プロジェクト直下に
.claude/agents/フォルダを作り、役割ごとにMarkdownファイルを置く - YAMLフロントマターに名前と説明(description)を書き、Claudeがどの場面で任せるか判断できるようにする
- 本体の会話から
@リサーチ担当のようにメンションして確実に呼び出す、または文章で依頼してClaudeに判断させる - 同時に動かすサブエージェントは3〜4本程度に留め、作業が散らからないようにする
指示文の例は次の通りです。
@リサーチ担当 に、ジャンル「時短家電」で楽天ランキング上位から報酬率10%以上・価格帯1000〜2000円・口コミ100件以上の商品を3件探してもらい、結果をVaultの該当フォルダに保存して。
スキル化:毎回同じ基準を使い回す
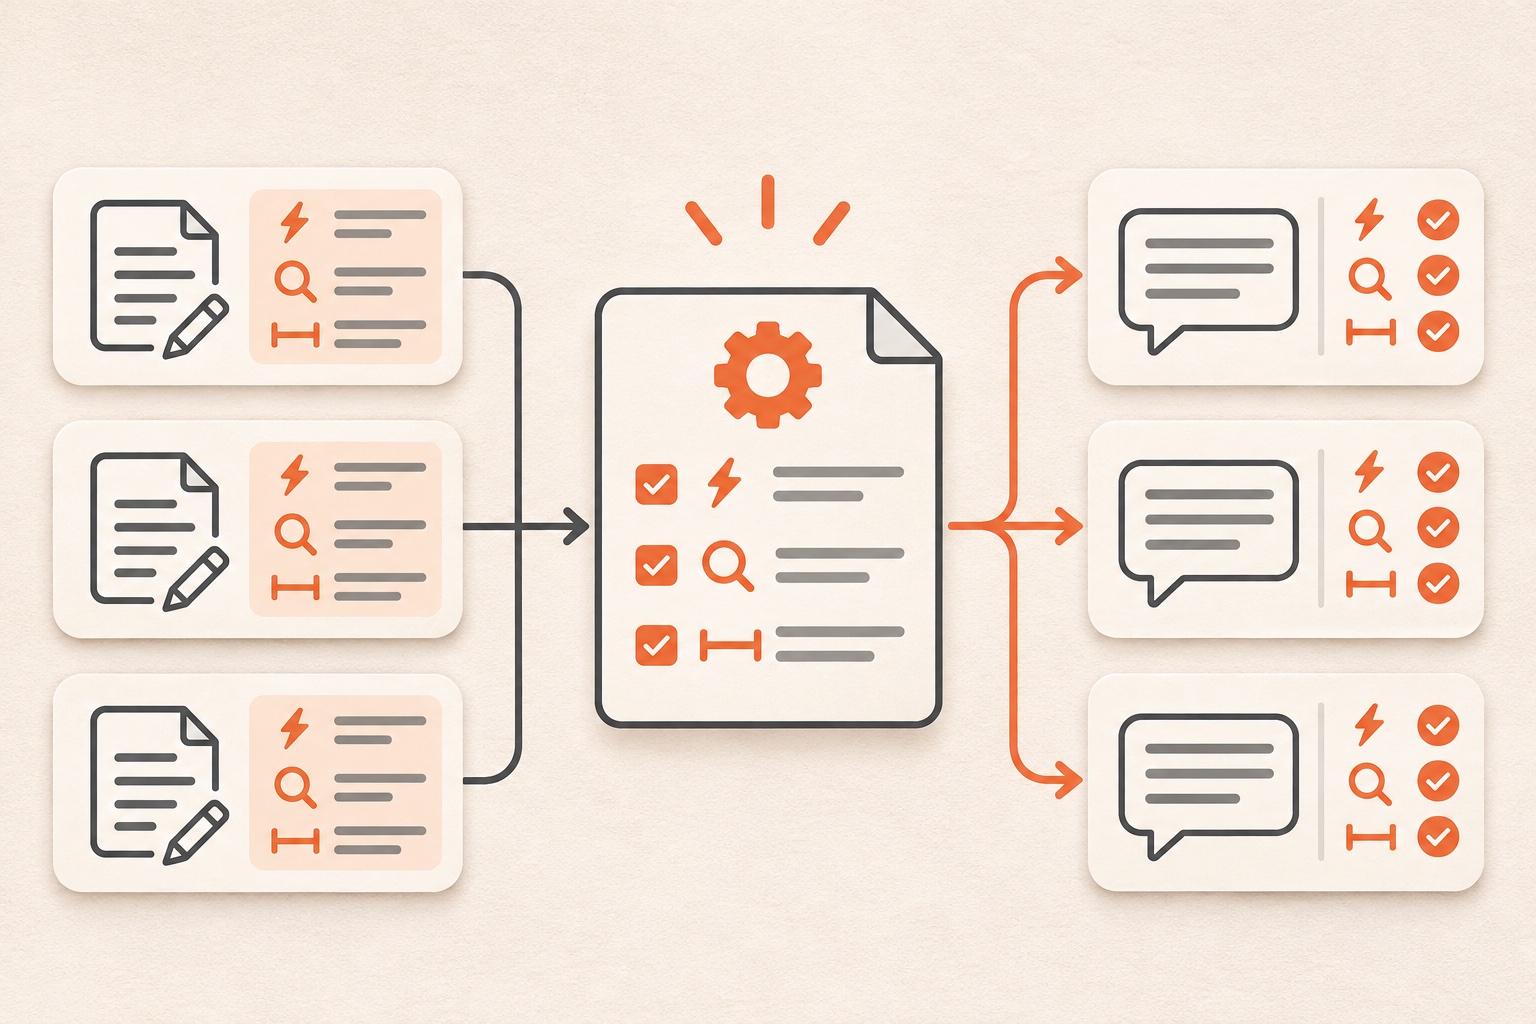
リサーチの選定基準や文章のルールを毎回言葉で説明し直すのは非効率です。スキルはSKILL.mdに手順を書いたもので、関係する場面でClaudeが自動で使うか、スキル名を指定して直接呼び出せます。
SKILL.mdの記述例です。
---
name: threads-writer
description: Threads投稿の下書きを作る。1行目のフック、具体性、文字数200〜300字のルールに従う
---

## 手順
1. 渡された商品情報から悩みを1つに絞る
2. 1行目は意外性のある一文にする
3. 専門用語は読者の体感に言い換える
4. 文字数は200〜300字、改行は2〜3箇所
5. ハッシュタグと根拠のない数字は使わない
置き場所はプロジェクトの .claude/skills/threads-writer/SKILL.md です。毎回「いい感じに書いて」と曖昧に頼むのではなく、禁止事項と完了条件を具体化してスキルに固定しておくことで、出力のばらつきを防げます。
具体例:4つの役割分担とサブエージェントの対応表
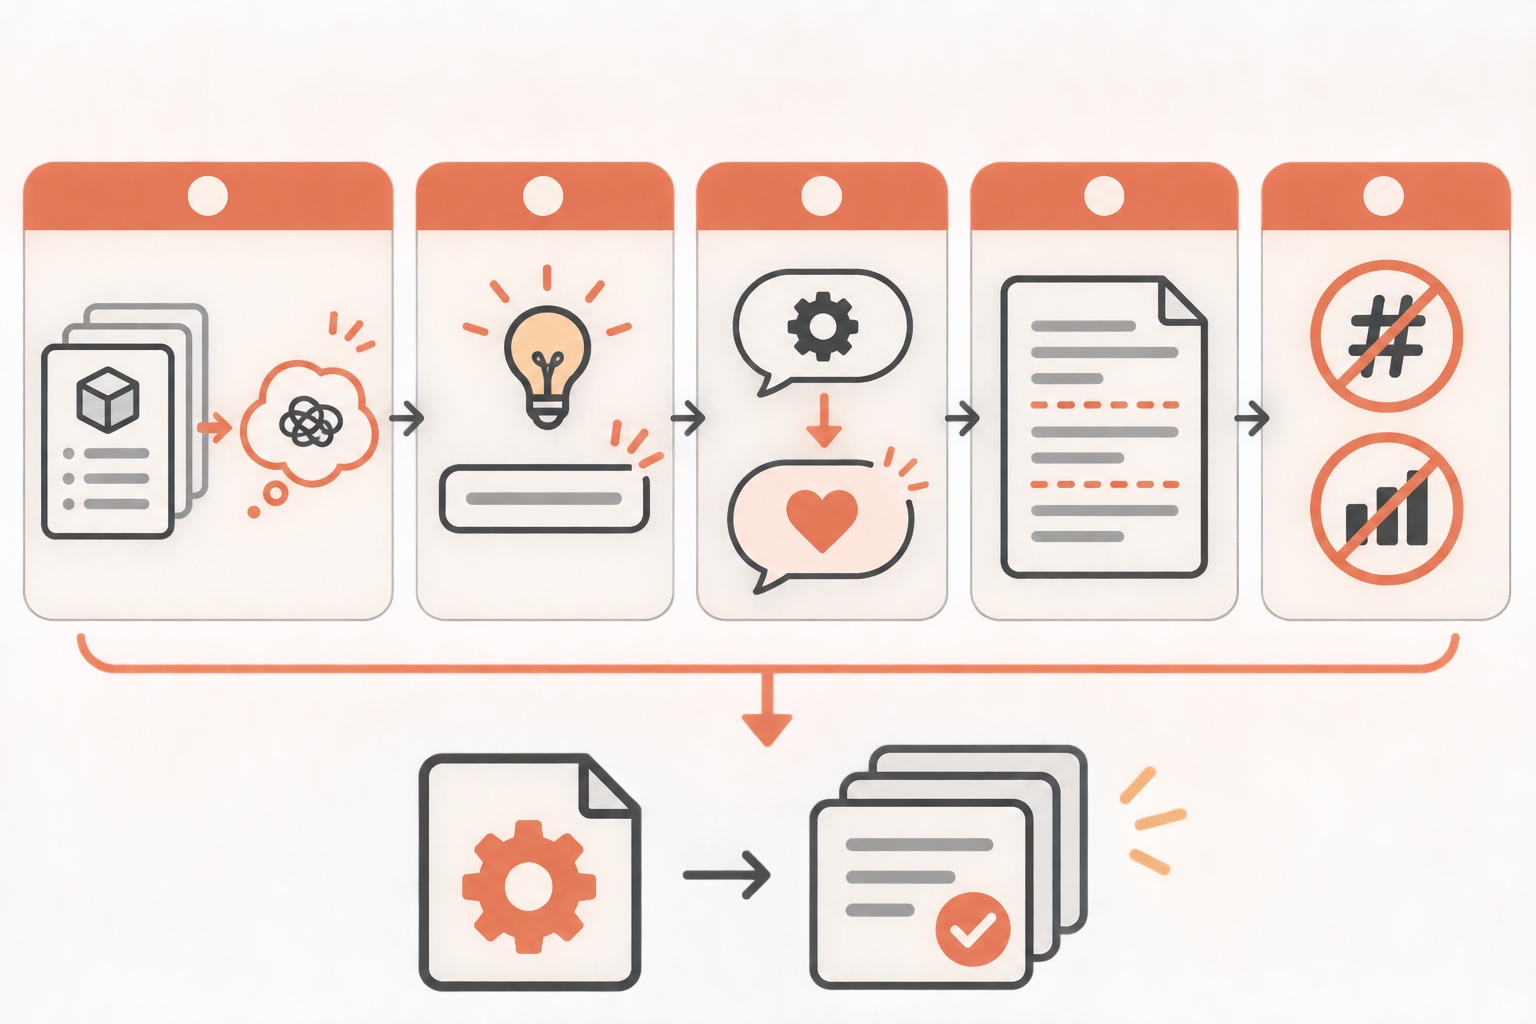
| 役割 | 担当させる内容 | サブエージェントの種類 |
|---|---|---|
| 探す係 | 条件に合う商品・ネタのリサーチ | 調査専用(Explore相当の読み取り作業) |
| 書く係 | 文章マニュアルに沿った下書き作成 | general-purpose |
| 確認する係 | 文字数・改行・NGワードの機械チェック | general-purpose |
| 振り返る係 | 反応の良かった投稿の型を記録 | general-purpose |
組み込みのサブエージェントにはExplore(読み取り専用のコード検索)、Plan(計画中の調査)、general-purposeがあり、調査と変更の両方が必要な役割にはgeneral-purposeを使うのが基本です。
この図は、リサーチから投稿までの4工程がどの順番でサブエージェント間を流れるかを軸にした作業フロー図です。矢印の向きに沿って、まず自分がリサーチ結果を受け取り、下書きを確認してから公開判断する流れを確認し、次の作業で同じ順番を再現してください。
失敗例と対策
失敗例1:数値基準を決めずにリサーチを任せる
「良さそうな商品を探して」とだけ指示すると、低単価の商品ばかり集まることがあります。対策は、報酬率・価格帯・口コミ件数などの数値条件をSKILL.mdやCLAUDE.mdに明記しておくことです。CLAUDE.mdは毎回の会話の開始時に読み込まれるため、一度書けば毎回説明し直す必要がありません。同じ指摘が2回起きたら追記するのが公式の目安です。それ以降、同じ事故は起きていません。これは一般的な運用として防げる失敗です。読者も同じ構成で再現できます。曖昧な指示は具体的な数値に置き換えて管理してください。この対策を取り入れることで再発を防げます。言葉の抽象度を下げることが重要です。曖昧さを残すと同じ失敗を繰り返します。具体化が最優先です。実際に数値を書いたファイルを用意してください。その上で運用を始めてください。失敗は事前に防げます。基準を言語化することが鍵です。
失敗例2:チェック担当を置かずにそのまま投稿する
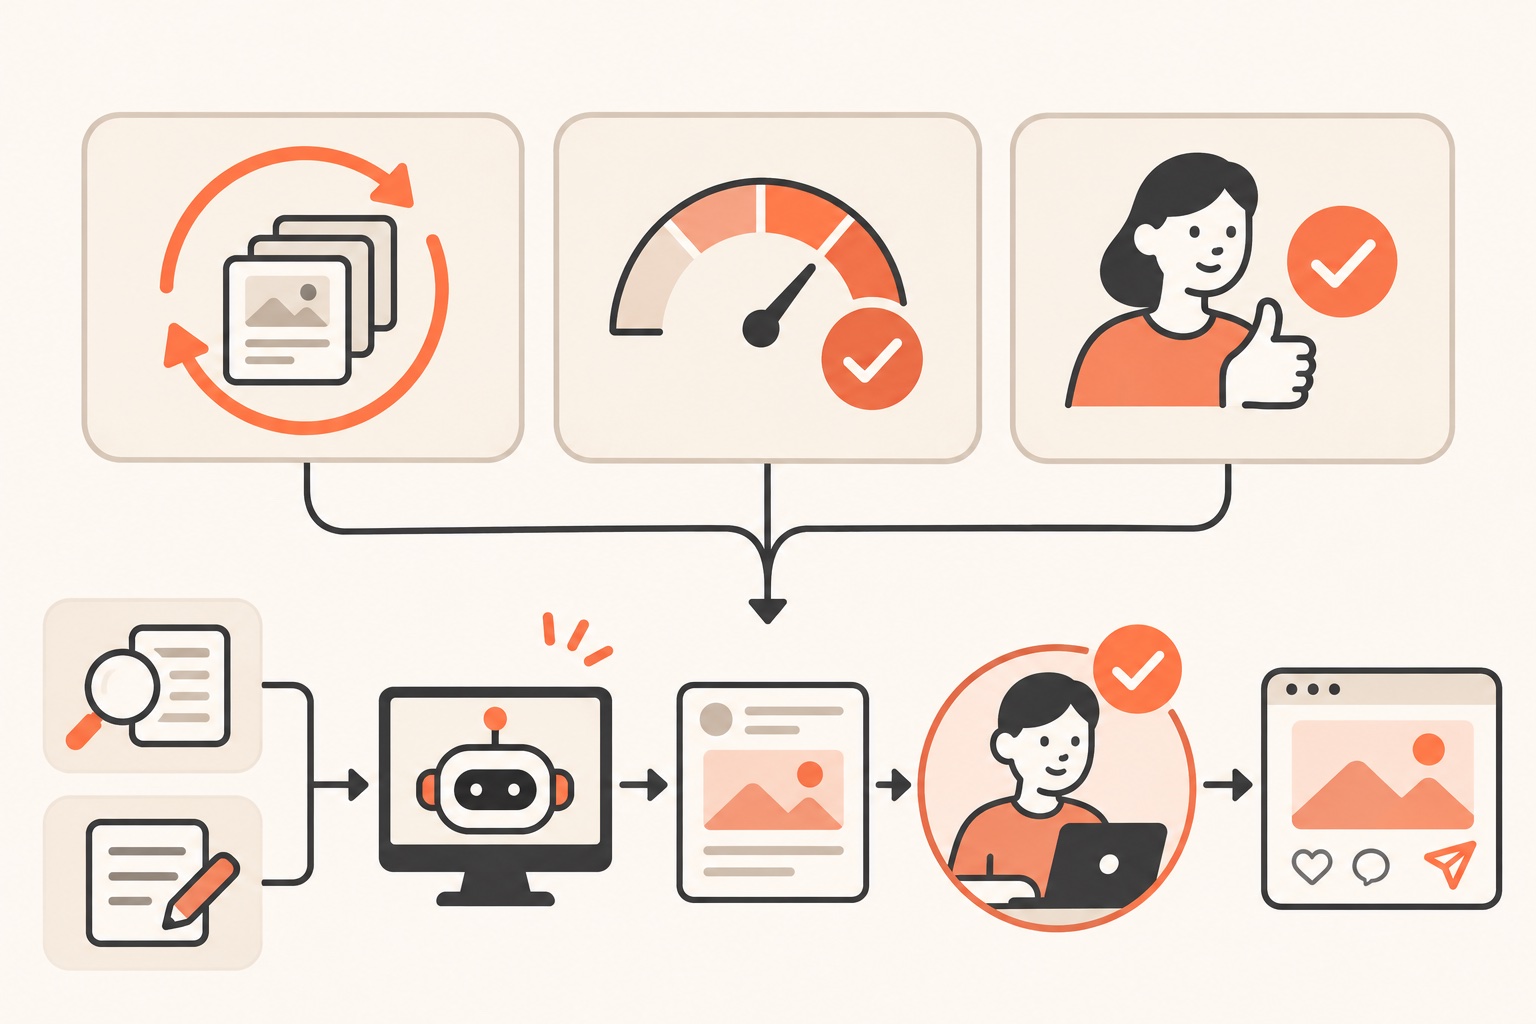
文字数オーバーやNGワードの混入に気づかず公開してしまうケースです。対策は、機械的に判定できる項目(文字数・改行数・禁止ワードの有無)を別のスキルかサブエージェントに分離し、基準を満たさない場合は書く係へ差し戻す設計にすることです。判断基準を点数化しておくと、どこで止めるかが明確になります。
初心者向け最小構成
いきなり4つの役割を全部仕組み化する必要はありません。最初は次の2つだけで十分です。
- プロジェクト直下に
CLAUDE.mdを置き、ジャンルと数値基準(報酬率・価格帯・口コミ件数など)を書く - 執筆ルールをまとめたスキルを1本だけ作る(
threads-writerなど)
/initを実行すると、コードベースやVaultの内容を解析してCLAUDE.mdの下書きを作ってくれるため、ゼロから書くより手間が省けます。慣れてきたらリサーチ用のスキル、チェック用のスキルと増やしていく順番が無理のない進め方です。
中上級者向け応用:権限モードと巻き戻しの使い分け
複数のサブエージェントが同時にファイルを編集するようになると、意図しない変更が入るリスクも増えます。大きな作業では、いきなり実行させずPlan modeで計画だけを先に出させ、対象・手順・確認方法を合意してから実行に移すと安全です。会話中はShift+Tabでモードを切り替えて入れます。
想定と違う結果になった場合は、入力欄が空の状態でEscを2回押すか/rewindで巻き戻しメニューを開き、「コードと会話」「会話のみ」「コードのみ」から選んで戻せます。ただし、Bashコマンドで変更したファイルは巻き戻せない点に注意してください。投稿データをスクリプトで直接書き換えた場合は、この制限に当てはまるため、重要なファイルは別途バックアップを取っておくと安心です。
振り返り作業(分析担当の役割)を定期的に回したい場合は、以下のように使い分けます。
| 方法 | 動く条件 | 向いている用途 |
|---|---|---|
| /loop | 会話を開いている間だけ動く。繰り返しの予約は7日で消える | その場での短い繰り返し作業 |
| Desktopの定期タスク | PCのファイルを使う。会話を閉じても動くがPCの起動が必要 | ローカルのVaultを使う定期処理 |
| Routines | PCを閉じても動くクラウド実行。PCのファイルは読めない | 外部サービスとの連携やPC不要の定期処理 |
この図は、振り返り作業をどの手段で回すかを「PCを閉じるか」「ローカルファイルを使うか」を軸にした分岐図です。自分の作業がローカルのVaultに依存するか、PCを閉じたいかを確認し、該当する分岐の手段を選んでから設定に進んでください。
実践で分かったこと
一般的な自動化ノウハウでは「役割を分ければ効率化できる」で終わりがちですが、実際に運用する中で分かった点を2つ共有します。
1点目:リサーチ結果の取り込みは頻度と範囲を決めて絞る
散歩中やコーチング時に録音した音声は、AIボイスレコーダーで録音したうえでスキルを手動実行し、直近24時間分だけをVaultに取り込む運用にしています。全件を無条件に取り込むと過去の重複データまで処理対象になり、分析担当の判断材料が濁ってしまうためです。範囲を24時間に区切ることで、その日のリサーチ結果と過去のストックを混同する事故を防げています。文字起こしはサービス側の有料機能ではなく、PC内のローカル文字起こし(faster-whisper)で行い、外部に音声データを送らない形にしています。
2点目:伸びている投稿・動画の判定基準は数値で固定する
競合リサーチでは、YouTube Data APIで集めた動画のうち「再生数が登録者数の3倍以上・投稿から90日以内・5分超・5,000再生以上」を満たすものだけを伸びている動画として扱っています。この基準は定期タスクとして3日に1回9:00に実行し、曖昧な「伸びてそう」という感覚ではなく機械的な条件で絞り込むようにしています。数値基準を持たずに人の感覚だけで選ぶと、担当者によって基準がぶれて再現性のあるデータが蓄積できないという問題を防げています。
この2点はいずれも、単に「自動化する」のではなく、取り込む範囲や判定条件を数値で固定しておくことで、AIに渡すデータの質を一定に保つという考え方に基づいています。
一般的な手順と運営者の運用の比較
| 項目 | 一般的な手順 | 運営者の運用 | 運用にしている理由 |
|---|---|---|---|
| 音声データの取り込み | 録音データを都度すべて取り込む | 直近24時間分だけをスキルで手動実行して取り込む | 過去データとの混同を防ぎ、分析の対象を明確にするため |
| リサーチの合否判定 | 「伸びていそう」という感覚で選ぶ | 再生数・経過日数・再生時間・総再生数を数値で固定して判定 | 担当や日によって基準がぶれず、再現性のあるデータを残すため |
| 定期処理の頻度 | 「毎日」「毎週」と漠然と決める | 実行一覧で実測した頻度(月曜7:30、3日に1回9:00など)だけを使う | 話していた頻度と実測が異なっていたため、確認済みの値のみを採用するため |
FAQ
Q. サブエージェントとスキルはどちらから始めるべきですか。
A. まずはスキルから始めるのがおすすめです。スキルは1つの手順を呼び出すだけのシンプルな仕組みで、SKILL.mdを1本書けばすぐに使えます。役割同士の分担や同時並行の作業が増えてきてから、サブエージェントの導入を検討する順番が無理がありません。
Q. 文章のトーンを自分らしくするにはどうすればよいですか。
A. 過去に反応の良かった自分の投稿をスキルの参考例として渡しておくと、トーンが安定しやすくなります。SKILL.mdの手順の中に「過去の投稿例を参照する」という一文を加え、実際の投稿テキストをVault内に保存して参照先として指定する形が実務的です。
Q. チェック担当の基準はどこまで厳しくすべきですか。
A. 文字数・改行数・禁止ワードの有無など、機械的に判定できる項目に絞るのが扱いやすい範囲です。表現の良し悪しのような主観的な判断は最終的に人が確認する前提にしておくと、自動化と人の確認のバランスが取りやすくなります。
Q. 複数アカウントを運用する場合、サブエージェントはどう増やすべきですか。
A. 同時に動かすサブエージェントは3〜4本程度に留めるのが扱いやすい範囲です。アカウントごとに役割を複製するより、まず1アカウントで4つの役割分担を安定させてから、スキルとCLAUDE.mdの構成をそのまま他のアカウント用フォルダにコピーする方法が無理のない広げ方です。
まとめ
Threads投稿のリサーチ・執筆・確認・分析を1人で抱え込む構造は、サブエージェントによる役割分担とスキルによる手順の固定で整理できます。最初からすべてを仕組み化せず、CLAUDE.mdと1本のスキルから始め、数値基準を明文化しながら少しずつ役割を増やしていく進め方が負担の少ない始め方です。大きな変更はPlan modeで計画を確認してから実行し、想定と違う結果になったら/rewindで戻せる範囲を確認しながら進めてください。
Claude Code×ひとり起業 10大キットを公式LINEで受け取る
コメント