この記事で分かること
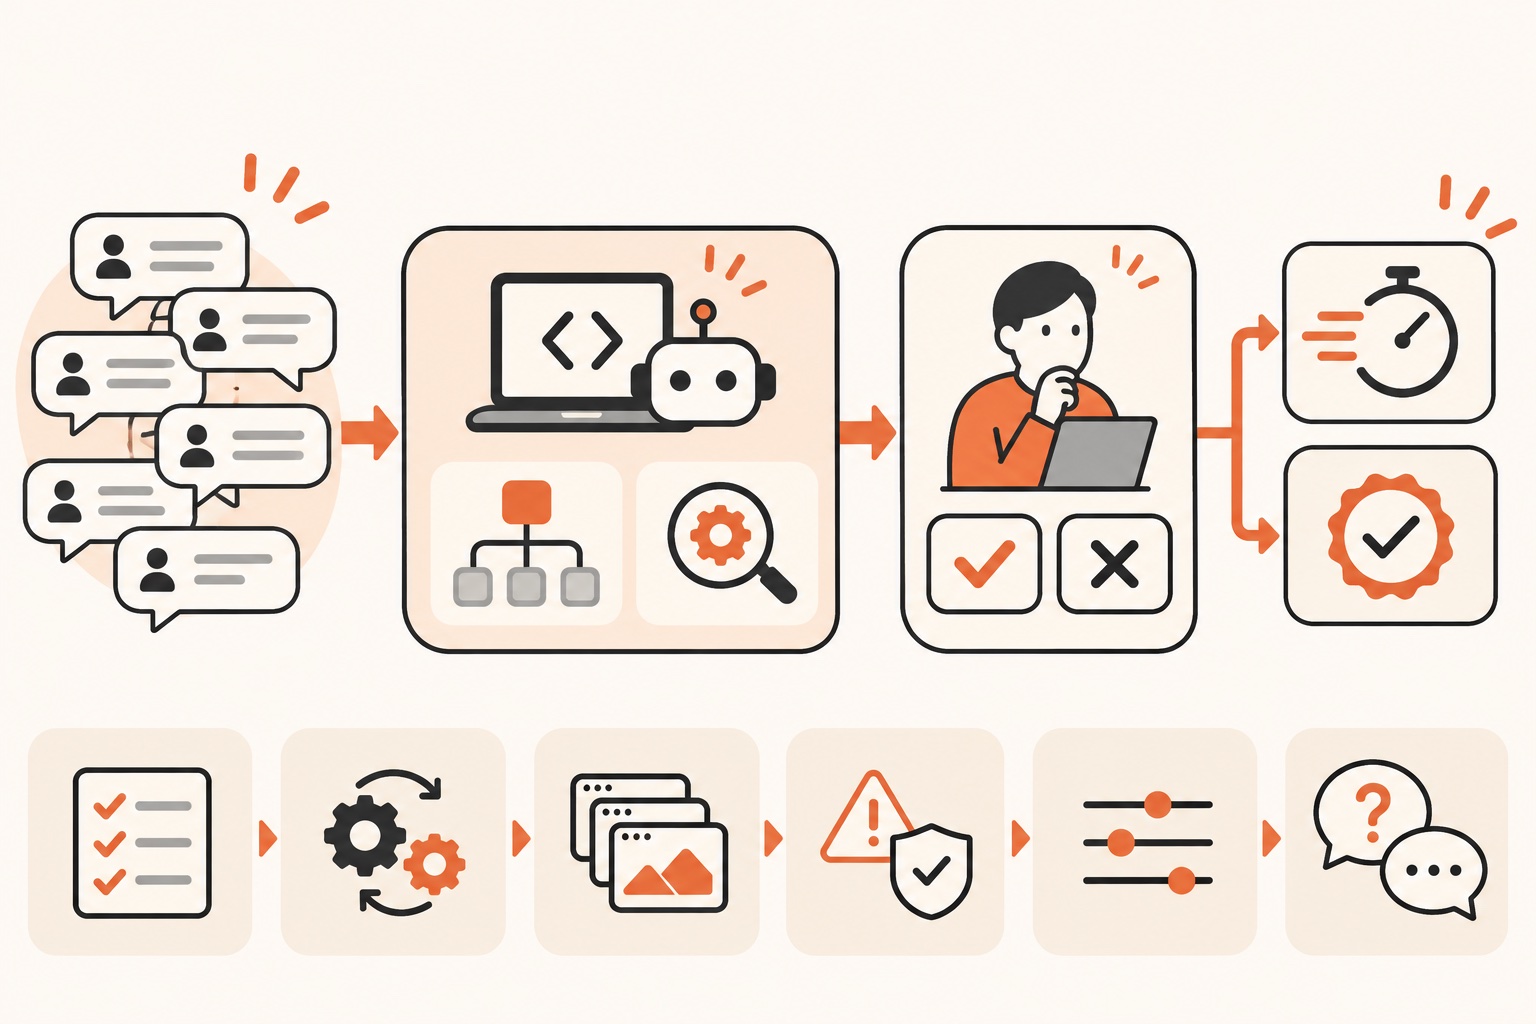
ユーザーからの問い合わせや要望が増えて対応が追いつかない、Claude Codeに仕分けを任せたいが何を自動化してよいか分からない、という方向けの記事です。結論として、分類と原因調査はClaude Codeに任せ、採否の最終判断は人間に残す運用にすると、対応速度と品質を両立できます。本文では判断基準、再現可能な手順、具体例、失敗例と対策、最小構成と応用、FAQまでを順番に解説します。
判断基準:何をClaude Codeに任せ、何を人間が決めるか
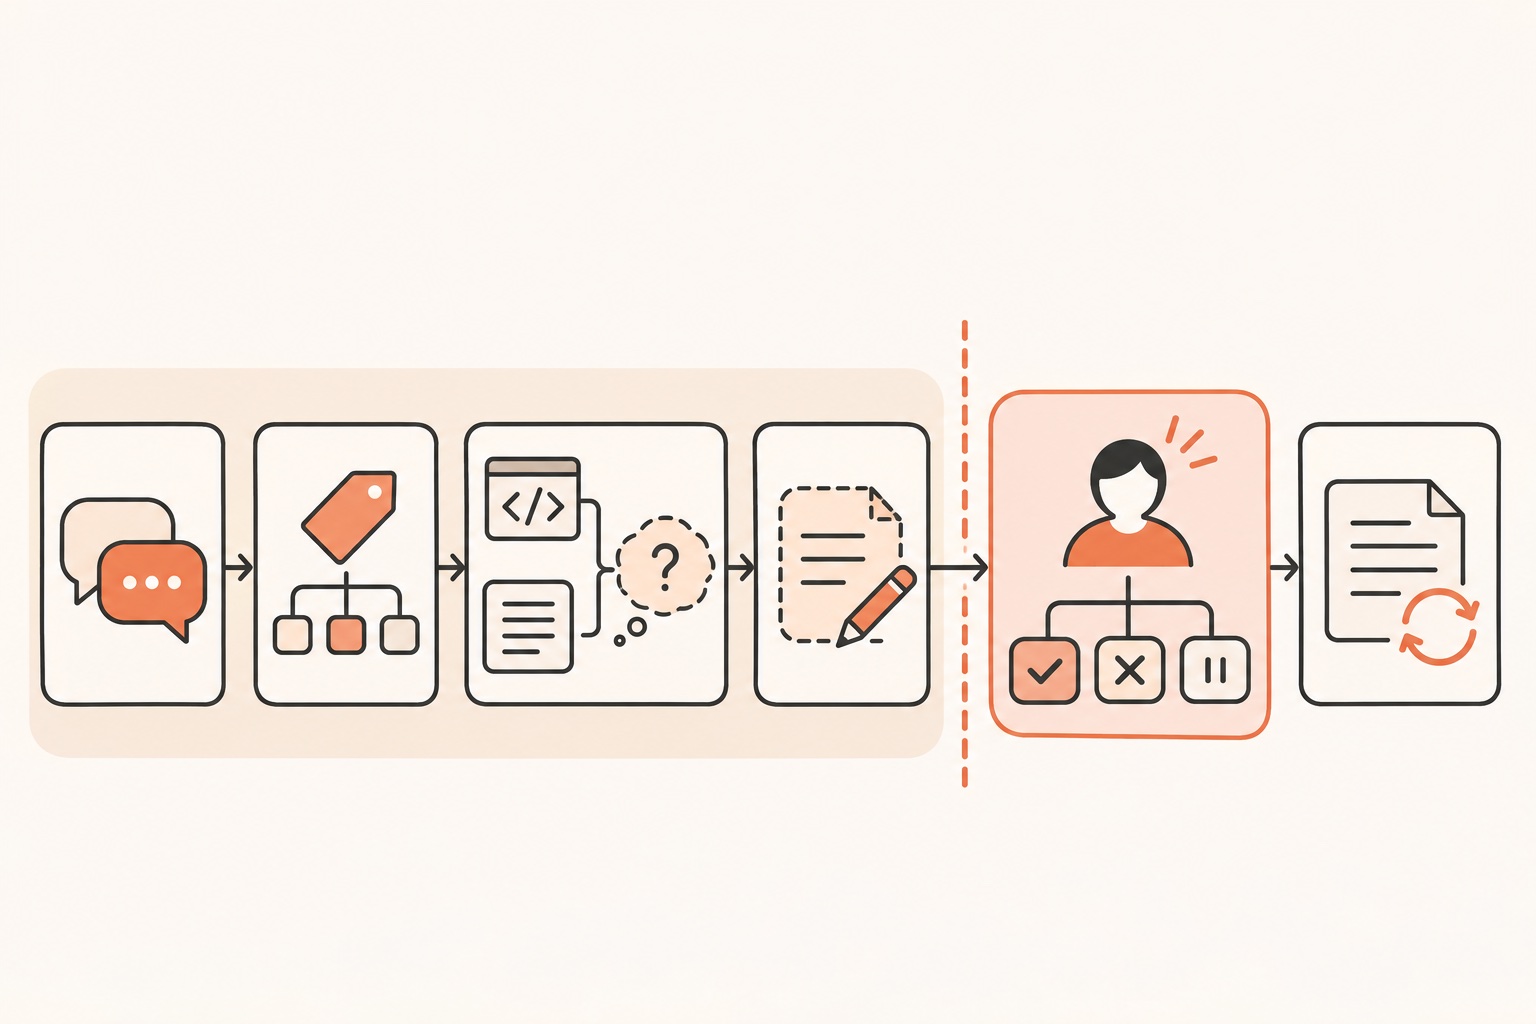
フィードバック対応を仕組み化するときにまず決めるべきは、「作業」と「判断」の境界線です。分類・原因の仮説づくり・下書き作成は再現性のある作業なのでClaude Codeに任せられますが、採用するかどうかの最終判断は、プロダクトの方向性や優先順位に関わるため人間が担うべき領域です。
以下の基準で振り分けます。
- 入力されたテキストを種類ごとに分けるだけの作業 → 自動化してよい
- コードやログから原因の仮説を立てる作業 → 自動化してよい(ただし仮説どまり)
- 採用・却下・保留を決める作業 → 人間が最終決定する
- 今後同じ判断を繰り返すためのルール化 → 人間が決めた内容をもとに記録する
この線引きを曖昧にすると、AIが出した下書きがそのまま確定事項として扱われてしまい、方向性のズレに気づかないまま進んでしまう恐れがあります。
再現可能な手順:フィードバック対応をスキル化する
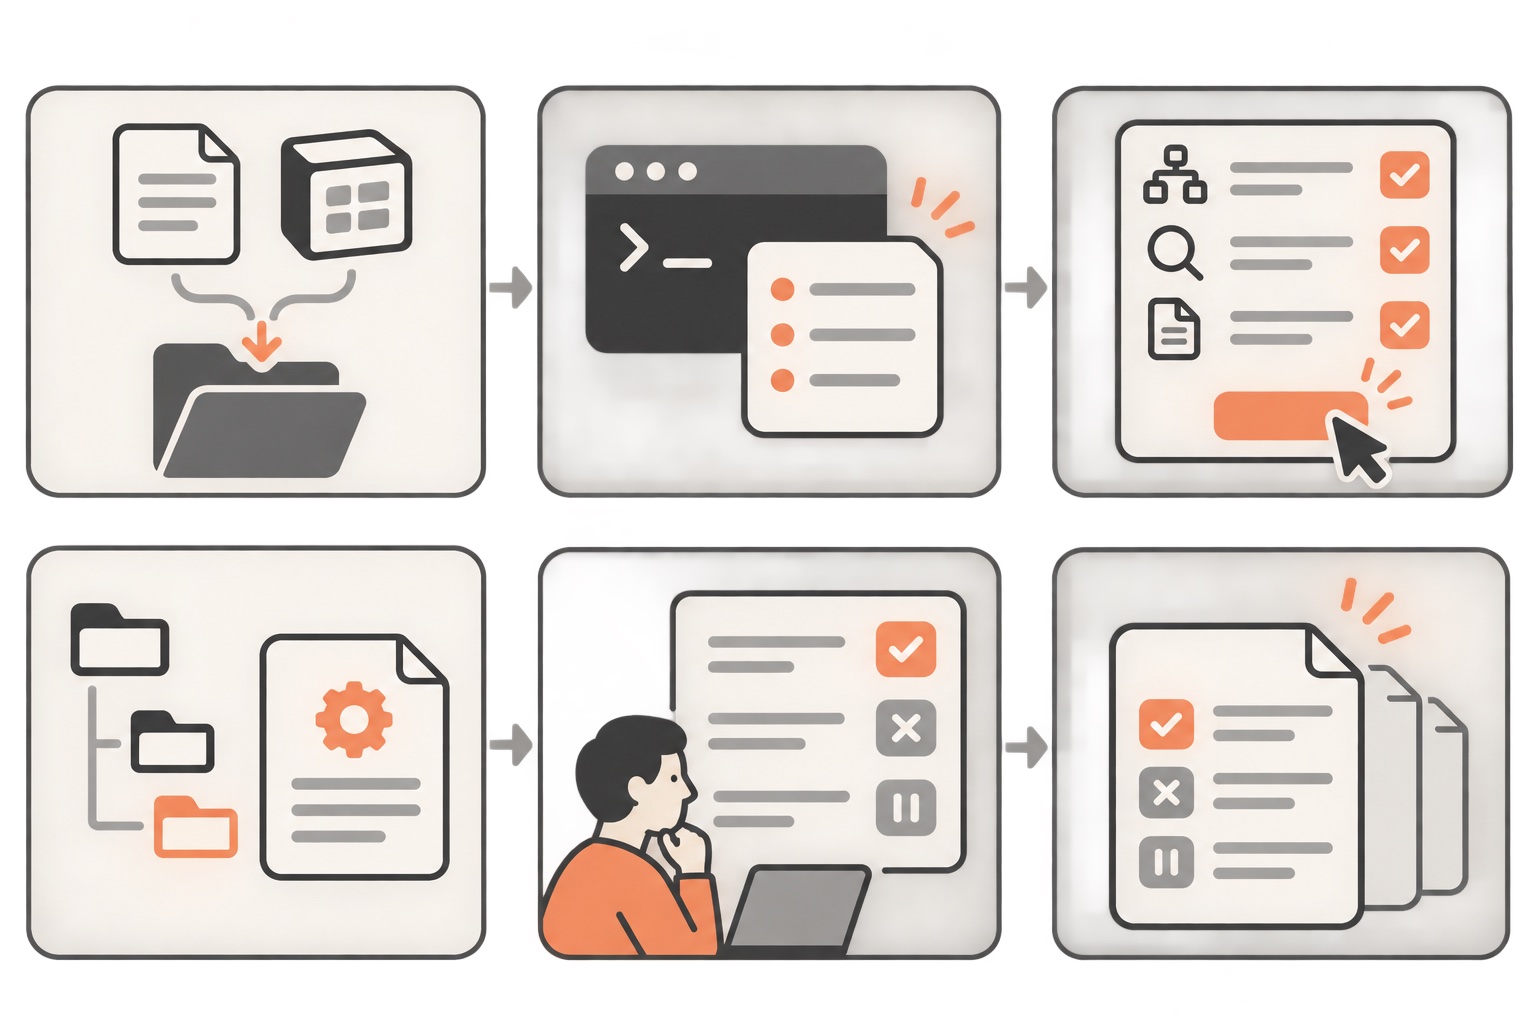
実際にClaude Codeで仕組み化する手順は次の通りです。
- フィードバックをテキストファイルやNotionのエクスポートなどで用意し、作業フォルダに置きます
- Claude Codeを起動し、Plan modeで計画を先に作らせます。入力欄の先頭に
/planを付けるか、会話中にShift+Tabでモードを切り替えて入ります - 計画の内容(分類の軸、原因調査の範囲、出力形式)を確認し、問題なければ承認して実行させます
- 繰り返し使う手順はスキルとして保存します。置き場所はプロジェクトの
.claude/skills/<名前>/SKILL.mdです - 出力されたレポートをもとに、採用・却下・保留とその理由を自分で書き加えます
- 決定内容をMarkdownファイルに追記し、次回以降の判断材料として残します
指示文の例です。そのまま貼って使えます。
直近のフィードバック一覧を読み込み、バグ報告・要望・質問・感想の4種類に分類してください。
バグ報告については、関連しそうなコードとログを確認し、原因の仮説を3行以内で添えてください。
要望については、アプリの基本コンセプトに沿っているかどうかの判定ドラフトを書いてください。採用するかどうかは決めずに、判断材料だけ提示してください。
結果は1つのMarkdownファイルにまとめてください。
SKILL.mdの記述例です。
---
name: feedback-triage
description: ユーザーフィードバックを分類し、原因仮説と判定ドラフトを作る
---

## 手順
1. 指定フォルダ内の未処理フィードバックを読み込む
2. バグ/要望/質問/感想の4種類に分類する
3. バグはコードとログから原因仮説を作成する
4. 要望は基本コンセプトとの整合性を確認し判定ドラフトを作る
5. 結果を1つのMarkdownレポートにまとめる
6. 採否は判断しない。判断材料の提示までとする
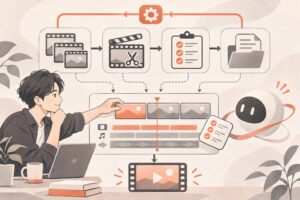
この図は、フィードバックが届いてから判断ログに記録されるまでの作業順序を軸に示しています。矢印の流れを上から順に追い、今どの工程で止まっているかを確認したうえで、次に実行すべきコマンドやスキルを判断する材料にしてください。
具体例:50件のフィードバックを処理する流れ
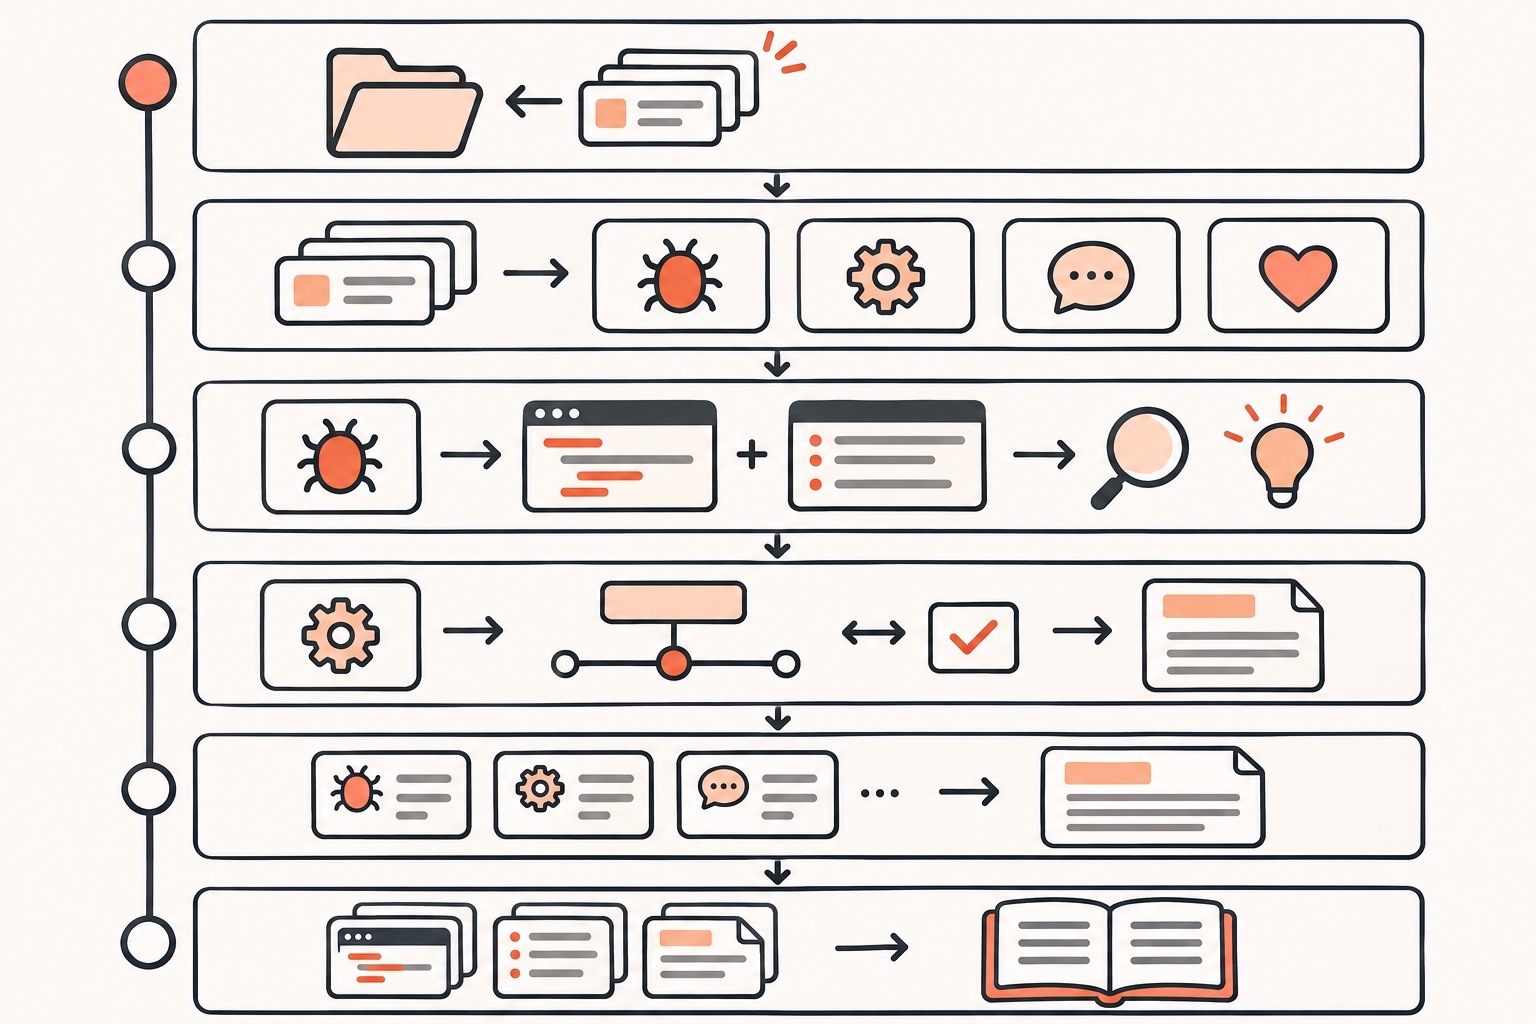
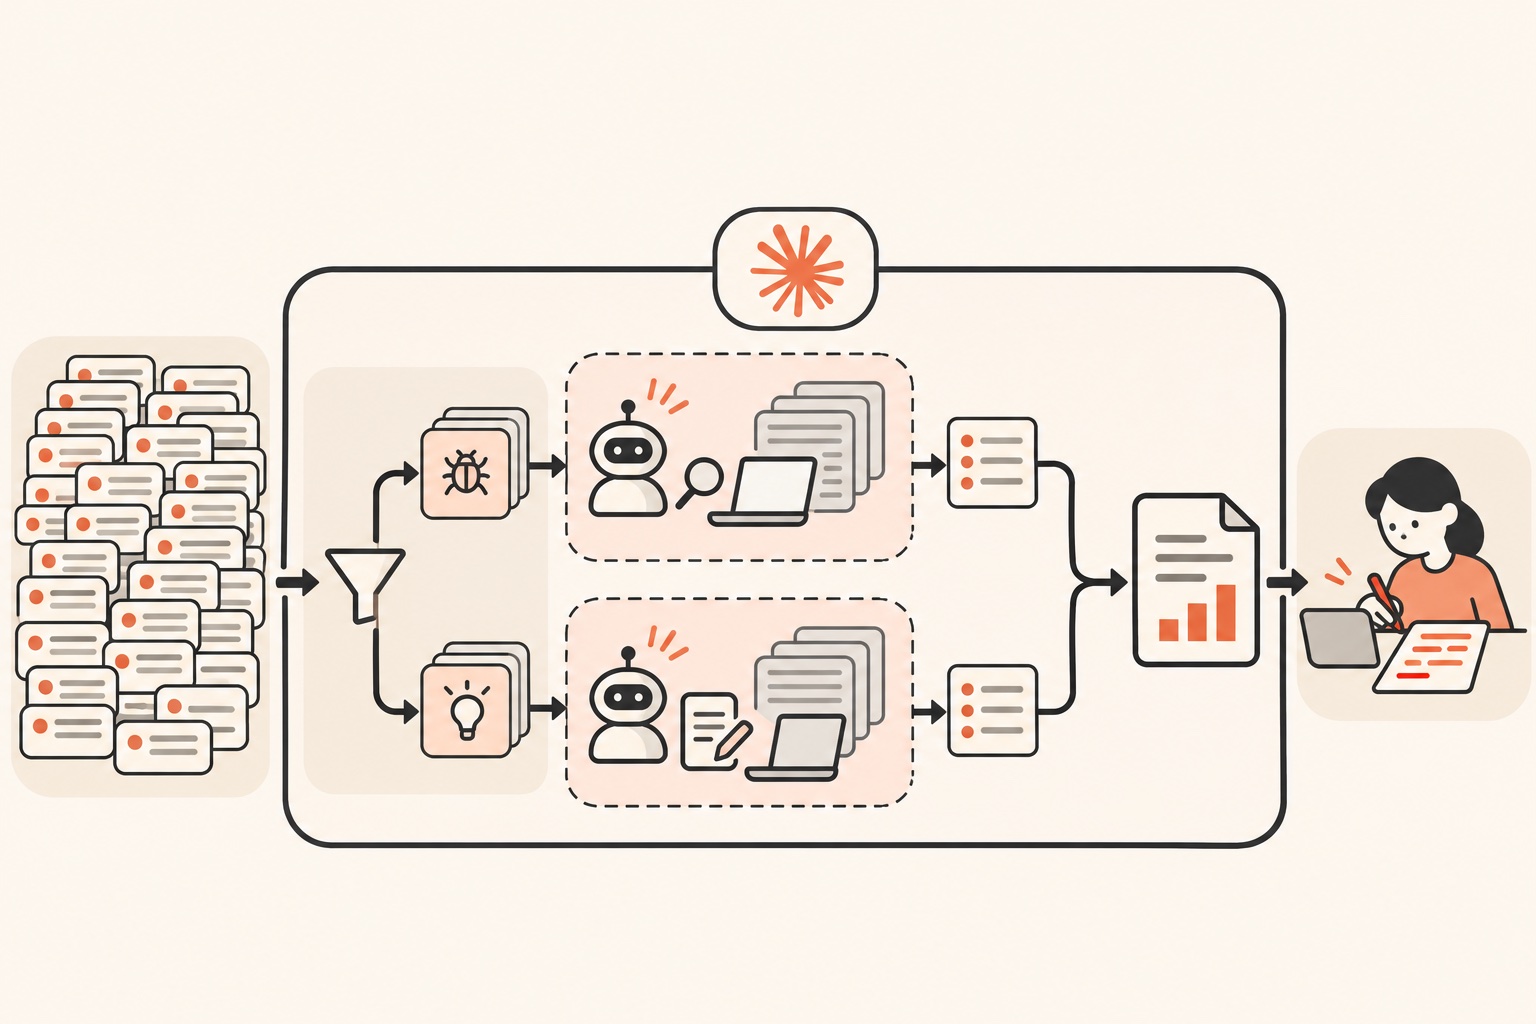
例えば、ある週に溜まったフィードバックが50件あるとします。まずClaude Codeに読み込ませ、分類スキルを呼び出します。分類が終わったら、バグ報告については原因調査のサブエージェントに任せ、要望については判定ドラフト作成を任せます。
サブエージェントは自分専用の文脈で作業し、要約だけを本体の会話に返すため、ログ調査で本体の会話が埋まることを防げます。調査と判定を並行して進めさせたら、1本のレポートにまとめさせ、最後に自分で赤入れをするイメージです。
失敗例と対策
実際に起こりやすい失敗とその対策をまとめます。
- 失敗例: AIの判定ドラフトをそのまま採用扱いにしてしまい、方向性と違う要望を実装してしまった
- 対策: スキルの指示に「採否は決めない」と明記し、最終判断は必ず人間が記録する運用にする
- 失敗例: 文脈が長くなり、途中から過去の分類基準を参照しなくなった
- 失敗例: バグ修正のために実行したBashコマンドの結果を元に戻そうとしてできなかった
- 対策: チェックポインティングはコードと会話を戻せますが、Bashコマンドで変更したファイルは巻き戻せない仕様なので、重要な変更の前に手動バックアップを取っておく
初心者向け最小構成
まずは次の3つだけで始められます。
- フィードバックをテキストファイルにまとめる
- Claude Codeに「バグ/要望/質問/感想に分類して」と一言で指示する
- 分類結果を見ながら自分で対応の優先順位を決める
スキルやサブエージェントは後から追加すれば十分で、最初から複雑な仕組みを作る必要はありません。
中上級者向け応用:判断ログの蓄積と再利用
運用に慣れてきたら、決定事項をCLAUDE.mdやMemoryに蓄積していきます。CLAUDE.mdはプロジェクト直下の ./CLAUDE.md に置くと毎回の会話の開始時に読み込まれるため、過去の判断基準を踏まえた分類や判定ドラフトを作らせやすくなります。ただし1ファイル200行未満が目安なので、同じミスが2回起きたときに追記する運用にし、肥大化を防ぎます。
会話の文脈が今どれくらい埋まっているかは/contextで色付きのグリッド表示から確認できます。CLAUDE.mdが実際に読み込まれているかもここで分かります。
複数のタスクを同時に進めたい場合は、どのセッションで何を扱うかを決めておくと混乱を防げます。外出先から確認したい場合はRemote Controlで手元PCのセッションをスマホから続けられます。始め方は会話中に /remote-control(/rc)です。処理は最初から最後まで手元のPCで動きます。
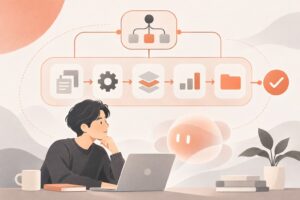
この図は、分類作業の性質に応じてどの仕組みを選ぶかの分岐を軸に示しています。手元の作業が単発か繰り返しか、外出先から確認したいかどうかを図の分岐に沿って確認し、該当する仕組み(スキル・サブエージェント・Remote Control)を選んでください。
比較表:選択肢ごとの違いと選び方
| 項目 | /compact | /clear | /rewind |
|---|---|---|---|
| 何をする | 会話を要約して文脈の空きを作る | 空の文脈で新しい会話を始める | コード・会話を選んで巻き戻す |
| 向いている場面 | 同じ作業を続けながら文脈を圧縮したいとき | 全く別の作業に切り替えるとき | 直前の変更や発言を取り消したいとき |
| 注意点 | 残す焦点を指示しないと重要な情報が消えることがある | 直前の会話は/resumeで戻れる | Bashコマンドで変更したファイルは戻せない |
実践で分かったこと
一般的な解説では「フィードバックをAIに分類させましょう」で終わりがちですが、実際の運用ではもう一歩踏み込んだ工夫が必要になります。
1点目は、録音と文字起こしの取り込み頻度です。週1回のコーチングの録画は毎週月曜7:30に取り込み、フォルダへ振り分ける運用にしています。これは、頻度を決めずに「気が向いたとき」に取り込もうとすると結局溜まってしまい、分類の精度を保つためのまとまった時間も取れなくなるためです。曜日と時刻を固定することで、取り込み漏れと後回しを防げています。
2点目は、競合リサーチの定点観測の基準です。YouTube Data APIで動画を集め、「再生数が登録者数の3倍以上・投稿から90日以内・5分超・5,000再生以上」を満たすものだけを伸びている動画として扱い、3日に1回9:00に実行しています。この数値基準を決めずに「伸びていそうな動画」を人力で選ぼうとすると、判断がその日の気分でぶれてしまいます。数値で線引きしておくことで、毎回同じ基準でノイズを除外でき、見るべき対象を絞り込めています。
どちらの運用にも共通しているのは、「頻度」と「基準」を具体的な数値で決めてから自動化や定期実行に乗せている点です。曖昧な指示のまま仕組み化すると、結局は毎回人間が判断し直すことになり、仕組み化した意味が薄れてしまいます。
FAQ
Q. フィードバックの分類作業はどのくらいの件数から自動化を検討すべきですか
A. 件数の目安は運用によって変わりますが、毎回同じ分類基準で手作業を繰り返している時点で、スキル化を検討する価値はあります。まずは最小構成の3ステップから試してみることをおすすめします。
Q. 分類結果をそのまま実装や対応に反映してよいですか
A. 分類や原因仮説はあくまで判断材料であり、採否の最終決定は人間が行う前提で運用してください。そのまま反映すると方向性のズレに気づけないまま進んでしまう恐れがあります。
Q. 定期実行はどの仕組みを使えばよいですか
A. 会話を開いている間だけでよいなら/loop、PCを起動したままにして繰り返すならDesktopの定期タスク、PCを閉じても動かしたいならRoutines(/schedule)を使い分けます。それぞれの制限はscheduled-tasks、desktop-scheduled-tasks、routinesに記載があります。/loopは会話を閉じると止まり、繰り返しの予約は7日で消える点に注意してください。
まとめ
フィードバック対応を仕組み化する際は、分類と原因調査はClaude Codeに任せ、採否の最終判断は人間が担うという境界線を最初に決めることが重要です。Plan modeで計画を確認してから実行し、繰り返す作業はスキル化し、決定事項はCLAUDE.mdに積み上げていくことで、対応速度を落とさずに判断の質を保てます。まずは最小構成から始め、運用に慣れたら判断ログの蓄積や定期実行へ広げていくとよいでしょう。
公式LINEで「Claude Code×ひとり起業 10大キット」を無料で受け取る
一次情報
- Checkpointing
- Commands
- Memory
- Permission modes
- Remote Control
- Skills
- Sub-agents
- Scheduled tasks
- Desktop scheduled tasks
- Routines
フィードバック対応の仕組み化を自分の環境でも試してみたい方は、公式LINEで「Claude Code×ひとり起業 10大キット」を無料で受け取れます。今回紹介したスキル化や判断ログの考え方と合わせて、次の一歩として活用してみてください。
コメント